01 Clinical Research · 临床研究
方法学图表
示意数据仅用于展示分析路径与表达方式,不代表真实项目结果。
示意数据 本页全部图表与数字均为示意数据(Synthetic illustrative data),由言拓致优用 R 模拟脚本生成,不指向任何真实患者、医院或委托方项目;生成脚本可按要求提供。
图注与解释边界
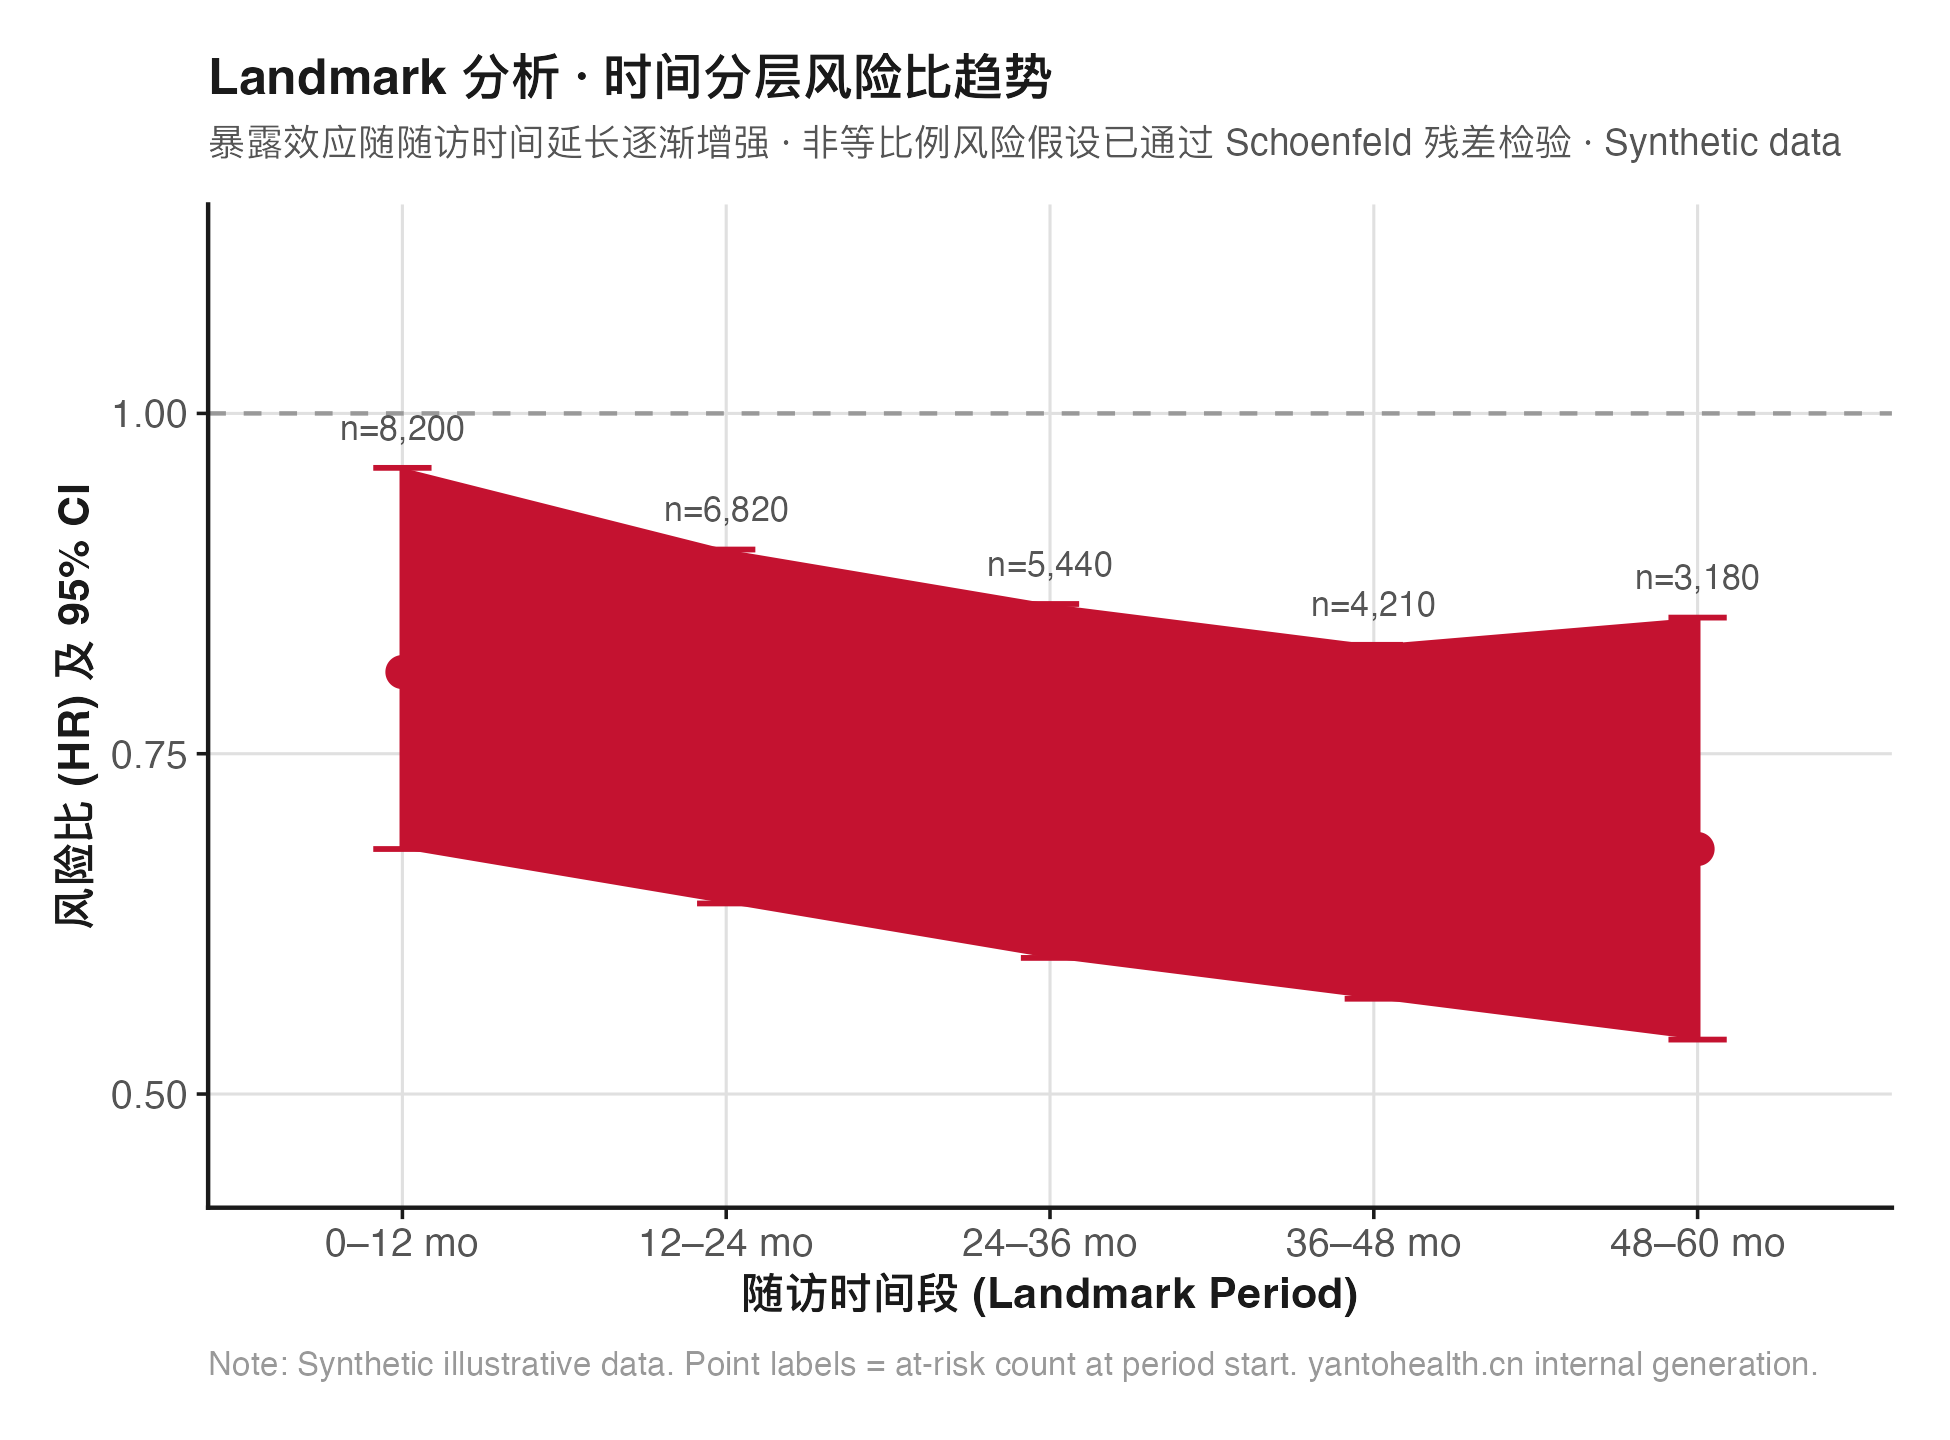
按 0–12 / 12–24 / 24–36 / 36–48 / 48–60 个月五个随访分段分别估计风险比(HR 0.81 → 0.68),各段点上方标注该段起始在险人数。比例风险假定结合 Schoenfeld 残差检验与图形评估;假定不成立时采用时依协变量或按时间分层处理。
图注与解释边界
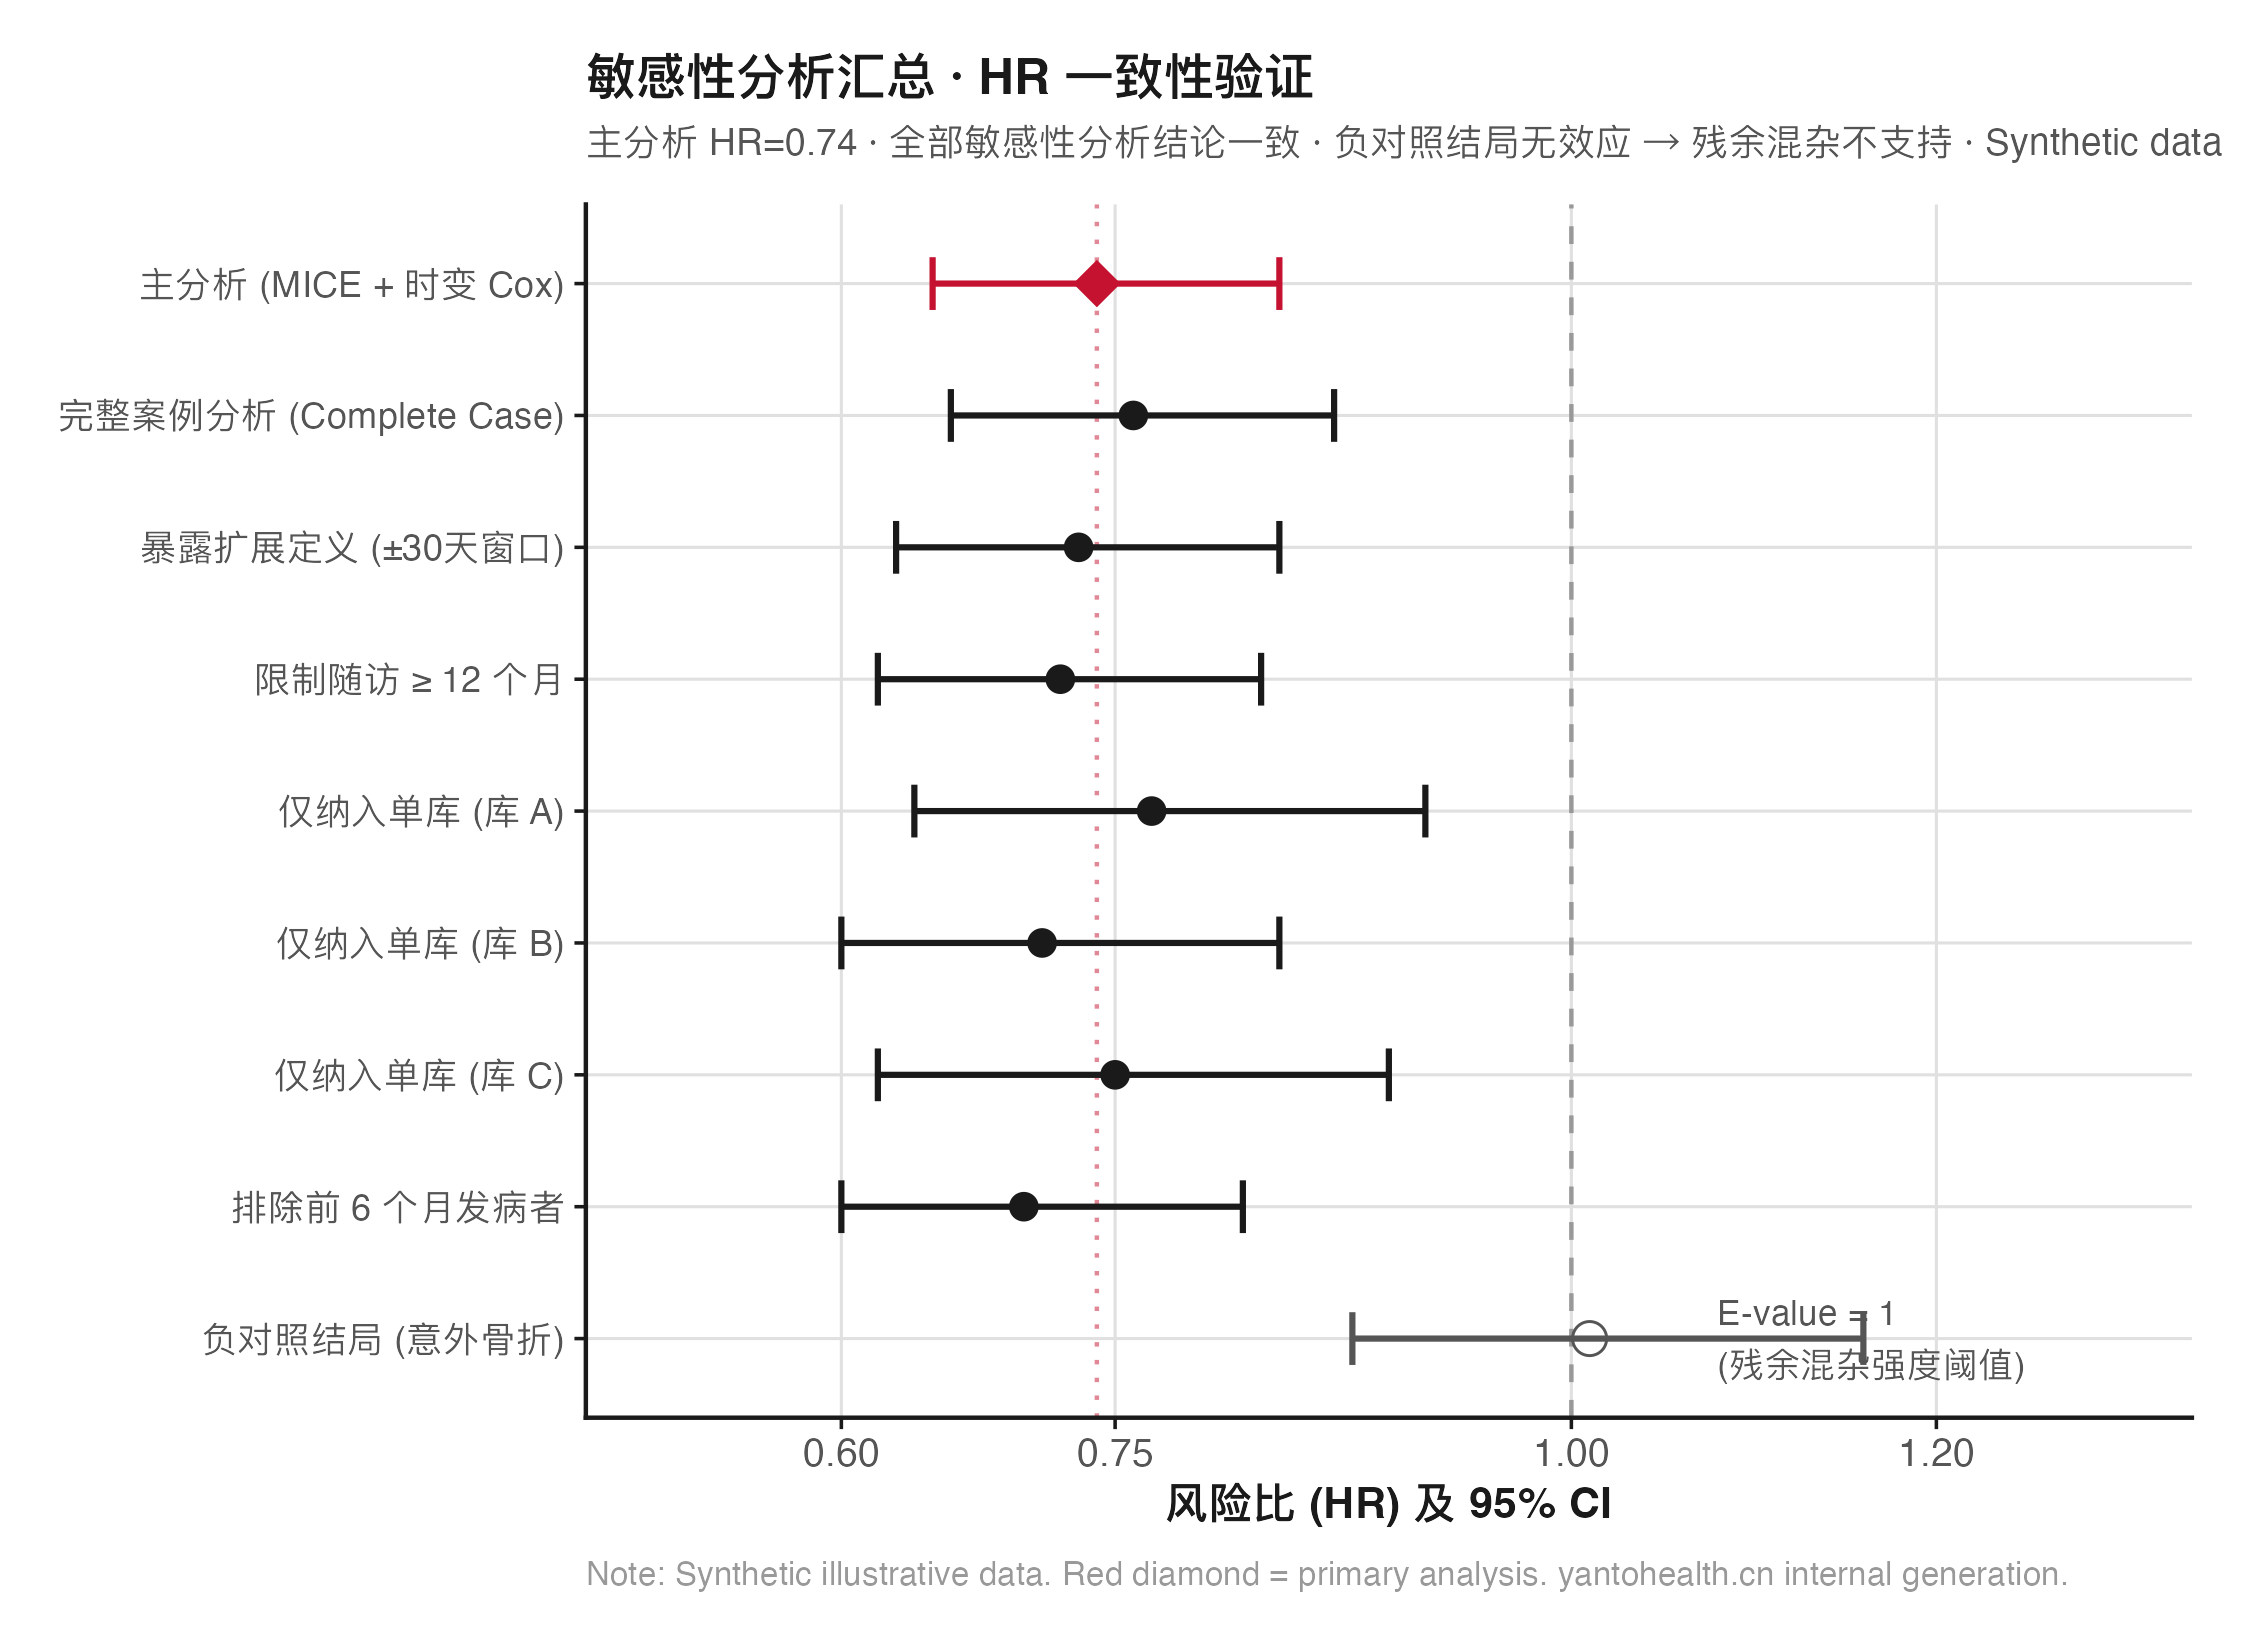
主分析(红色菱形)与 10 项敏感性分析的效应量方向一致;负对照结局(示意)HR=1.01(95% 置信区间(CI) 0.88–1.16),跨过无效线。该负对照结局仅为示意,实际研究须选择与暴露无已知因果关联的结局;负对照未见关联也不能排除残余混杂。图内 E-value 按 VanderWeele 与 Ding(2017)公式计算:HR 点估计对应 2.04,95% CI 上限对应 1.67(以结局罕见、HR 近似 相对风险(RR) 为前提)。
02 Clinical Research · 临床研究
方法学风险
医保数据库、电子病历(EMR)等真实世界数据(RWD)的方法学挑战与 随机对照试验(RCT) 截然不同:数据量大但质量参差、ICD 编码存在版本差异和临床使用习惯偏差、合并症记录不完整、以及大量与时间相关的偏倚来源,包括 Immortal Time Bias、时变混杂与竞争风险。
审稿阶段的高频质询包括两类:第一,暴露起点(index date)定义不清晰,致使 immortal time 进入分析,从而系统性地使暴露组呈现虚假的"保护效应";第二,长期慢性病研究忽视时变协变量:患者在随访期间的合并症、用药、血压等状态动态变化,若仅以基线值建模,效应估计将存在偏倚。
本类研究的方法学重点:严格的 ICD 编码映射 + 暴露-随访时间轴对齐 + 多重插补处理大规模缺失 + 时变协变量 Cox 模型 + 系列预设敏感性分析(见第 05 步与 Fig 2) + 负对照结局分析 + E-value。
- Immortal time bias:暴露窗口与随访起点错位
- ICD-9/ICD-10 混合编码未统一映射
- 合并症/用药记录缺失比例较高,且未评估缺失机制
- 时变协变量仅使用基线值(时间性混杂)
- 多数据库队列合并时未检验队列间一致性
- 长随访期未考虑竞争风险事件
03 Clinical Research · 临床研究
分析框架
ICD 编码映射与数据标准化
构建 ICD-9 → ICD-10 双向映射表(含临床常用同义码),逐库核查主诊断、次诊断、手术操作码的编码一致性。输出标准化变量字典 + 每个关键变量在各库中的频率分布对比;频率分布异常通常提示编码习惯差异,需在方法节说明处理策略。
暴露-随访时间轴精确定义
明确三个时间点:①队列入组日期(cohort entry date)②暴露起点(index date,必须 ≥ entry date)③事件发生或删失时间(event/censor date)。entry → index 之间的"等待期"若计入暴露组随访时间,将产生 immortal time bias。使用 landmark analysis 或 time-conditional exposure 定义规避。
大规模缺失值处理(链式方程多重插补(MICE) 多重插补)
真实世界数据缺失率通常较高(如实验室指标缺失 15–40%)。MICE(多重链式方程插补)生成 10–20 个插补数据集,逐数据集建模后用 Rubin's rules 合并效应量。插补模型中纳入结局变量(生存结局纳入事件指示变量与 Nelson-Aalen 累积风险),否则插补值与结局的关联被削弱,关联估计将偏向无效值(Moons 等, 2006;White 与 Royston, 2009),报告各关键变量缺失率矩阵。
时变协变量 Cox 回归
将随访期内动态变化的协变量(血压、用药状态、合并症)处理为时变格式(counting process format:start-stop 数据结构)。时变 Cox 模型使用 R 的 survival 包,tmerge() 函数构建时变数据框。比例风险假定检验仍适用(Schoenfeld 残差),违反则引入时间分层。
敏感性分析与负对照验证
围绕主分析开展系列敏感性分析:① 完整案例分析 vs MICE 多重插补对比;② 暴露定义扩展(±30 天窗口);③ 限制随访 ≥ 12 个月;④ 按数据库来源分别单库分析;⑤ 排除入组前 6 个月内发病者;⑥ 不同随访截止时间。另开展负对照结局分析(理论上不受暴露影响的结局,用于探测残余混杂信号),并计算 E-value 量化残余混杂需要达到的强度阈值。
04 Clinical Research · 临床研究
审稿质询与预防
以下为按报告规范条目整理的方法学示意写法,不是任何真实审稿意见的转载,也不代表特定期刊或审稿人。
关于 immortal time bias
示意意见 · 非真实审稿意见
The exposure definition requires at least 90 days of continuous medication use, but follow-up begins at cohort entry. Patients who survive the first 90 days are by definition immortal during that period. This immortal time has been incorrectly assigned to the exposed group, potentially creating a spurious protective association.
预防策略:使用"暴露起点 = 满足暴露定义后的时间点"作为随访计时起点(index date approach),或在方法节明确说明如何将 immortal time 归入"未暴露"时段(time-conditional analysis)。在方法节单独一段描述时间轴定义,并用 Figure 直观展示 entry date / index date / event date 三个时间点的关系。
关于数据库质量与编码误差
示意意见 · 非真实审稿意见
The study relies on administrative claims data, which are known to have coding errors and misclassification. The accuracy of the exposure and outcome definitions based on ICD codes has not been validated against medical records. This introduces substantial measurement error that may bias the results in unpredictable directions.
预防策略:在方法节引用该编码定义的既往验证研究(如有),或说明本研究采用的是该疾病领域内公认的 ICD 定义算法(附参考文献)。将主要结局的 ICD 编码列表作为附件提供。在讨论局限性中承认编码误差可能性,并说明使用多个诊断码("至少 2 次诊断记录")的设计如何降低假阳性率。
关于多数据库一致性
示意意见 · 非真实审稿意见
The authors combined four separate cohorts from different databases. No assessment of inter-database heterogeneity is provided. Differences in coding practices, patient populations, and data collection methods across databases may compromise the validity of pooled estimates.
预防策略:在汇总分析前先按数据库来源进行分层分析,用 I² 描述队列间异质性程度(同时报告 τ²)。若各库效应量方向一致,说明合并的临床合理性;合并所用效应模型(固定效应或随机效应)在分析计划中预先设定并在方法节说明,不依据 I² 数值临时切换。各库基线特征对比表(Table 1 的扩展版)作为附件提供。
05 Clinical Research · 临床研究
交付文件
| 交付文件 | 规格与内容 |
|---|---|
| ICD 编码映射表 + 数据质量核查报告 | ICD-9/10 双向映射清单、各数据库关键变量频率分布对比、缺失率矩阵。可作为 Supplementary Table 提交。 |
| 时间轴定义文档 + 可视化图 | Entry date / Index date / Event date 三时间点定义书面说明,配套 Figure 示意(可作为正文 Figure 1 或附件),明确说明 immortal time 的处理方式。 |
| MICE 多重插补代码 + 插补诊断图 | mice 包 R 代码(含插补模型规格),插补收敛诊断图(trace plots),10–20 套插补数据集 + Rubin's rules 合并结果报告。 |
| 时变 Cox 建模代码 + 图表包 | tmerge() 时变数据构建 + survival::coxph() 模型 + 时变 Kaplan-Meier 曲线 + 亚组分析森林图,代码 + 300 DPI TIFF 图表随交付打包。 |
| 敏感性分析汇总表 + E-value | 敏感性分析结果汇总(含 MICE vs 完整案例对比、负对照结局分析结果)+ E-value 计算书,可直接用于方法节和讨论节引用。 |
| 常规收集健康数据观察性研究报告规范(RECORD) / 流行病学观察性研究报告规范(STROBE) 报告规范对照表 | 按 RECORD(真实世界与常规收集健康数据研究的 STROBE 扩展)逐条核查,标注对应正文位置,可直接作为投稿 Reporting Checklist 附件提交。 |
06 Clinical Research · 临床研究
委托范围与说明
医院信息系统数据的结构评估
可以处理,但须在签订合同前完成数据结构评估。评估内容包括:数据导出格式(Excel/CSV/Access数据库)、关键变量是否具备唯一患者 ID、时间变量是否完整(入院/出院/诊断/用药日期),以及关键变量的缺失情况。若基础数据结构严重不完整(如缺少可跨表关联的患者 ID、关键时间变量或多数关键变量缺失),将如实告知是否具备继续开展的价值,不在未完成数据评估前承接项目。
4 个数据库的差异与合并条件
标准做法为:先按数据库来源进行分层子分析,检验各库效应量的方向与大小是否一致,再决定是否合并。Table 1 提供各库基线特征对比(含标准化均值差),方法节说明库间异质性的检验方法。若各库结果存在实质性差异,则不予强行合并,并将该差异作为研究发现之一在讨论节中阐述。
超过 10 年随访与时变混杂
技术层面可以处理,计算成本处于可接受范围。关键决策点在于确定需处理为时变形式的协变量:通常选择随访期内确有显著变化的变量(用药状态、关键合并症、关键检验指标),基线相对稳定的人口学变量则保持为固定协变量。时变变量的选择依据需在方法节中说明。需注意:若时变混杂因素同时受既往暴露影响(暴露与混杂之间存在反馈),在时变 Cox 模型中直接调整这类变量可能导致偏倚,此时需考虑边际结构模型(逆概率加权)等 g 方法(Robins 等, 2000)。
负对照结局分析的解释边界
负对照结局(Negative Control Outcome)是一种用于探测残余混杂的敏感性分析手段:选择一个与暴露因素无已知因果关联、但可能与主结局受相同混杂因素影响的结局(Lipsitch 等, 2010),若该结局的分析同样显示"保护效应"或"风险增加",提示可能存在未被调整的残余混杂或其他系统偏倚;反之,未见关联也不能排除残余混杂。项目启动阶段将与委托方共同确定适宜的负对照结局,并以领域文献确认其与暴露无已知因果关联,分析结果纳入敏感性分析部分。
相关服务
Get Started · 方法学评估
预约方法学评估
提交研究问题、已有数据与期望产出后,24 小时内回复(工作日优先),首次回复即提供可行性意见、可行的统计路径与推荐套餐。
本公司在论文中的参与如实披露:符合国际医学期刊编辑委员会(ICMJE)作者标准的,以本公司真实单位署名;其余在致谢中写明。是否录用由期刊编辑部与同行评议决定,本公司不作发表结果承诺。